前言
之前在 V2EX 上发了两篇关于 DataZen 的帖子,尤其是上一篇发完之后有很多朋友到 github 上给了 star ,特别感谢大家的支持,同时也有很多朋友提出了宝贵的意见,让我意识到这个赛道的竞争到底有多激烈。重量级传统选手有 Navicat/DataGrip/DBeaver/TablePlus 等等,最近的 DBX 也很火功能也很强大。既然这个赛道竞争这么激烈,我为啥还要继续做 v0.2.0 版本呢,实事求是的说,一个是 vibe coding 极大的降低了开发成本,另一个也是寻求一个技术人的最后尊严吧:还想在这个代码急剧贬值的时代证明自己的价值,我可以不写代码了,但是我依然可以做出一个架构良好的软件,我做的软件依然比绝大部分零编程基础的人用 vibe coding 出来的软件要好。接下来就给大家简单介绍一下 DataZen 的大体架构。
DataZen 的大体架构
总体上来说,DataZen 采用的是 Host + 插件的架构。插件又包括运行时插件、编译期插件以及外观主题插件、Workspace App 。
一、编译期插件(驱动插件)
编译期主要是用来支持不同的数据库 driver ,这个方案的灵感来自 Caddy 的 xcaddy 方案:在编译前选择我需要使用到的功能模块,通过编译脚本将所需模块写入 main.go 中的 import 部分,编译后就自然带上了选择好的功能模块。那为啥用这个方案呢?主要是 rust 的 ABI 兼容做得不咋地,如果做成 DDL 会存在不可控的二进制兼容性问题。当然也可以考虑将驱动做成独立的进程,host 和驱动插件之间通过进程间通信来控制数据库操作,但这个方案相对比较复杂,暂时不考虑。
Driver 插件有几个要考虑的点:
- 既然是走插件架构,那就要做到插件相关的逻辑不能污染侵入到 host 中,比如不能在 host 中有
if driver == 'postgre'这种代码,必须保证 host 对具体 driver 的内部实现逻辑是无感知的。要做到这一点,就要设计好一套 driver api 接口规范,各个 driver 插件按照这个 api 接口规范来实现,driver 通过 host 提供的注册机制将自己注册到 host 的 supported drivers 中,host 只会调用 driver api 接口中定义好的方法,不会直接显式调用某个 driver 的方法。用 java 的话来说就是:面向接口编程。 - 不同的 driver 所需要的前端页面也会存在一些差异,比如 redis 这类 NoSQL 数据库就不适用 SQL 编辑器。为了解决这个问题,在 driver 包里除了和数据库打交道的 rust 代码,还引入了展现层需要的前端 react ui 代码。当然并不是每个驱动都需要实现自己的前端 UI 代码,host 默认提供了一套面向 SQL 的 UI 界面,只有像 redis/mongodb 这样的数据库才需要自己重新实现一遍前端页面。
- 驱动测试代码也不能写到 host 中,因为 host 不知道最终会有哪些驱动是需要加入到最终的编译过程的。
- 编译流程怎么办?怎么做到类似 xcaddy 的按需编译?这一块是通过开发一套编译脚本,在编译时指定
--drivers=mysql,postgresql,redis,xxx来选择要打包进可执行程序的驱动来实现的。
二、运行时插件
这部分主要是为了解决 UI 增强问题,实现时参考了 VSCode 中 Extension Point 的做法:在 host 中定义好可以通过 extension 来进行扩展的扩展点,由 extension 覆盖注册扩展点挂载函数,运行时 host 会调用 extension 的挂载函数,然后由 extension 接管相关功能。这部分是在 v0.2.0 版本中引入的,主要是做了 SQLEditor 的编辑体验增强。
三、主题插件
这个就比较简单,主要是通过定义 css 变量等方式对主题进行覆盖
四、Workspace App
从产品形态上来看,Workspace app 更像是 chrome 的 extension:允许插件编写完整的 html 页面,可在页面内执行内嵌/本地 JS ,通过 postMessage 和 host 进行通信。host 也会暴露自身的一些能力给 workspace app ,比如查询连接列表、执行 SQL 等。
1. Workspace App 能干什么?
举个例子:我有个应用,应用内配置保存在数据库中,配置比较复杂,我想比较生产环境和测试环境的配置差异。针对这类需求,做法可能有几种:
- 写复杂 SQL 分别从测试环境和生产环境获取到配置内容,然后再裸眼比较
- 写个 脚本/小程序 分别从测试环境和生产环境获取到配置内容,再用脚本获取差异
- 做得更好一点,在某个 console 里做个页面,分别拉取数据进行比较
- 用 DataZen 的 Workspace App 来实现可视化比较
2. 为什么要用 Workspace App 来做?
用 Workspace App 来做是因为 vibe coding 时代,写代码已经成本极低,AI 在短时间内完全可以做出一个专业的差异对比页面(当然你也可以 vibe coding 一个页面+本地 server 实现相同效果,但使用 Workspace App 的好处是能统一管理数据库凭证等信息)。
3. 怎么做?
丢一个 Workspace App 开发规范和示例给编码 agent ,再描述请求需求,让 AI 给你打工。喝喝咖啡上个 V2EX 摸一下鱼,一会赛博打工人就给你整好了。
说说为什么要选插件架构
先说个题外话:这个项目其实从去年就开始做了,之前选型用的是 tauri + sevlte ,当时选 sevlte 主要是看重它没有虚拟 dom 带来的高性能。但开发过程中一直没有解决 macos 上的焦点以及事件在父子组件之间传递的问题,进展缓慢。大概两个月前,决定重写,这次让 AI 参与技术选型决策,AI 选了 React😂。但确实换成 React 之后,很多之前一直没解决的问题一下子就容易解决起来了(当然也有模型能力提升的原因)。
趁着重写的契机,重新思考了软件架构,最终决定采用插件架构,主要考虑点有几个:
- 不是所有人都需要同时支持那么多类型数据库,可能大多数人只需要 mysql+redis ,需要给这类人一个自己 DIY 的机会。
- 我们公司内部访问线上数据库是有专门的 web 平台,只能提供 http 接口,而且也不合适在开源软件里直接包含调用公司内部平台的代码。
- 对哪些像我一样需要用到一些特殊驱动但是又不想开源的人来说,需要给他们一条实现自己需求的路径。
- 后续可以扩展插件商店,支持付费驱动或者增强功能体验。我始终认为有付费可能的生态才会是一个健康的生态:有人愿意付费就会有人愿意开发对应的需求。
最后,说点开发过程中的体会
- 现在的顶尖模型真的很强,但我大部分时候都是用的二线模型和免费模型,能做到这个程度很大因素是会经常回头看架构是否合理,是否有需要调整的地方,并且经常整理系统架构文档,开发规范文档等,这一步确实比较重要,让 AI 绝大部分时间都是在正确的方向上。
- 有时候担心自己对某个问题描述不明确,这时我会跟简单描述我的问题,然后让 AI 开 subagent 去解决问题,parent agent 在向 subagent 派发任务的时候会把问题描述得更清楚。我不确定这是否是最佳实践,但从结果来看效果还不错。
- 测试过程真的很痛苦。功能不是开发完了直接丢出来就好了,发布之前仍然需要做很多的测试,作为一个桌面端应用,很多时候仍然免不了手工测试。虽然在项目中做了很多自动化测试,但仍免不了手动测试。作为一个后台开发,这真的很痛苦。
- 随着开发过程不断的深入,发现 DataZen 和竞品差距仍然很大,有好几次都想放弃,但是还是坚持了下来。在这里要真心的感谢 V2EX 的网友们,是你们给的 github star 带个了我很大的动力。
最最后,打个广告
v0.2.0 新功能
<video src="https://flyxl.github.io/datazen/assets/video/demo-recording.mp4" controls width="100%" poster="https://flyxl.github.io/datazen/assets/video/demo-poster.png"></video>
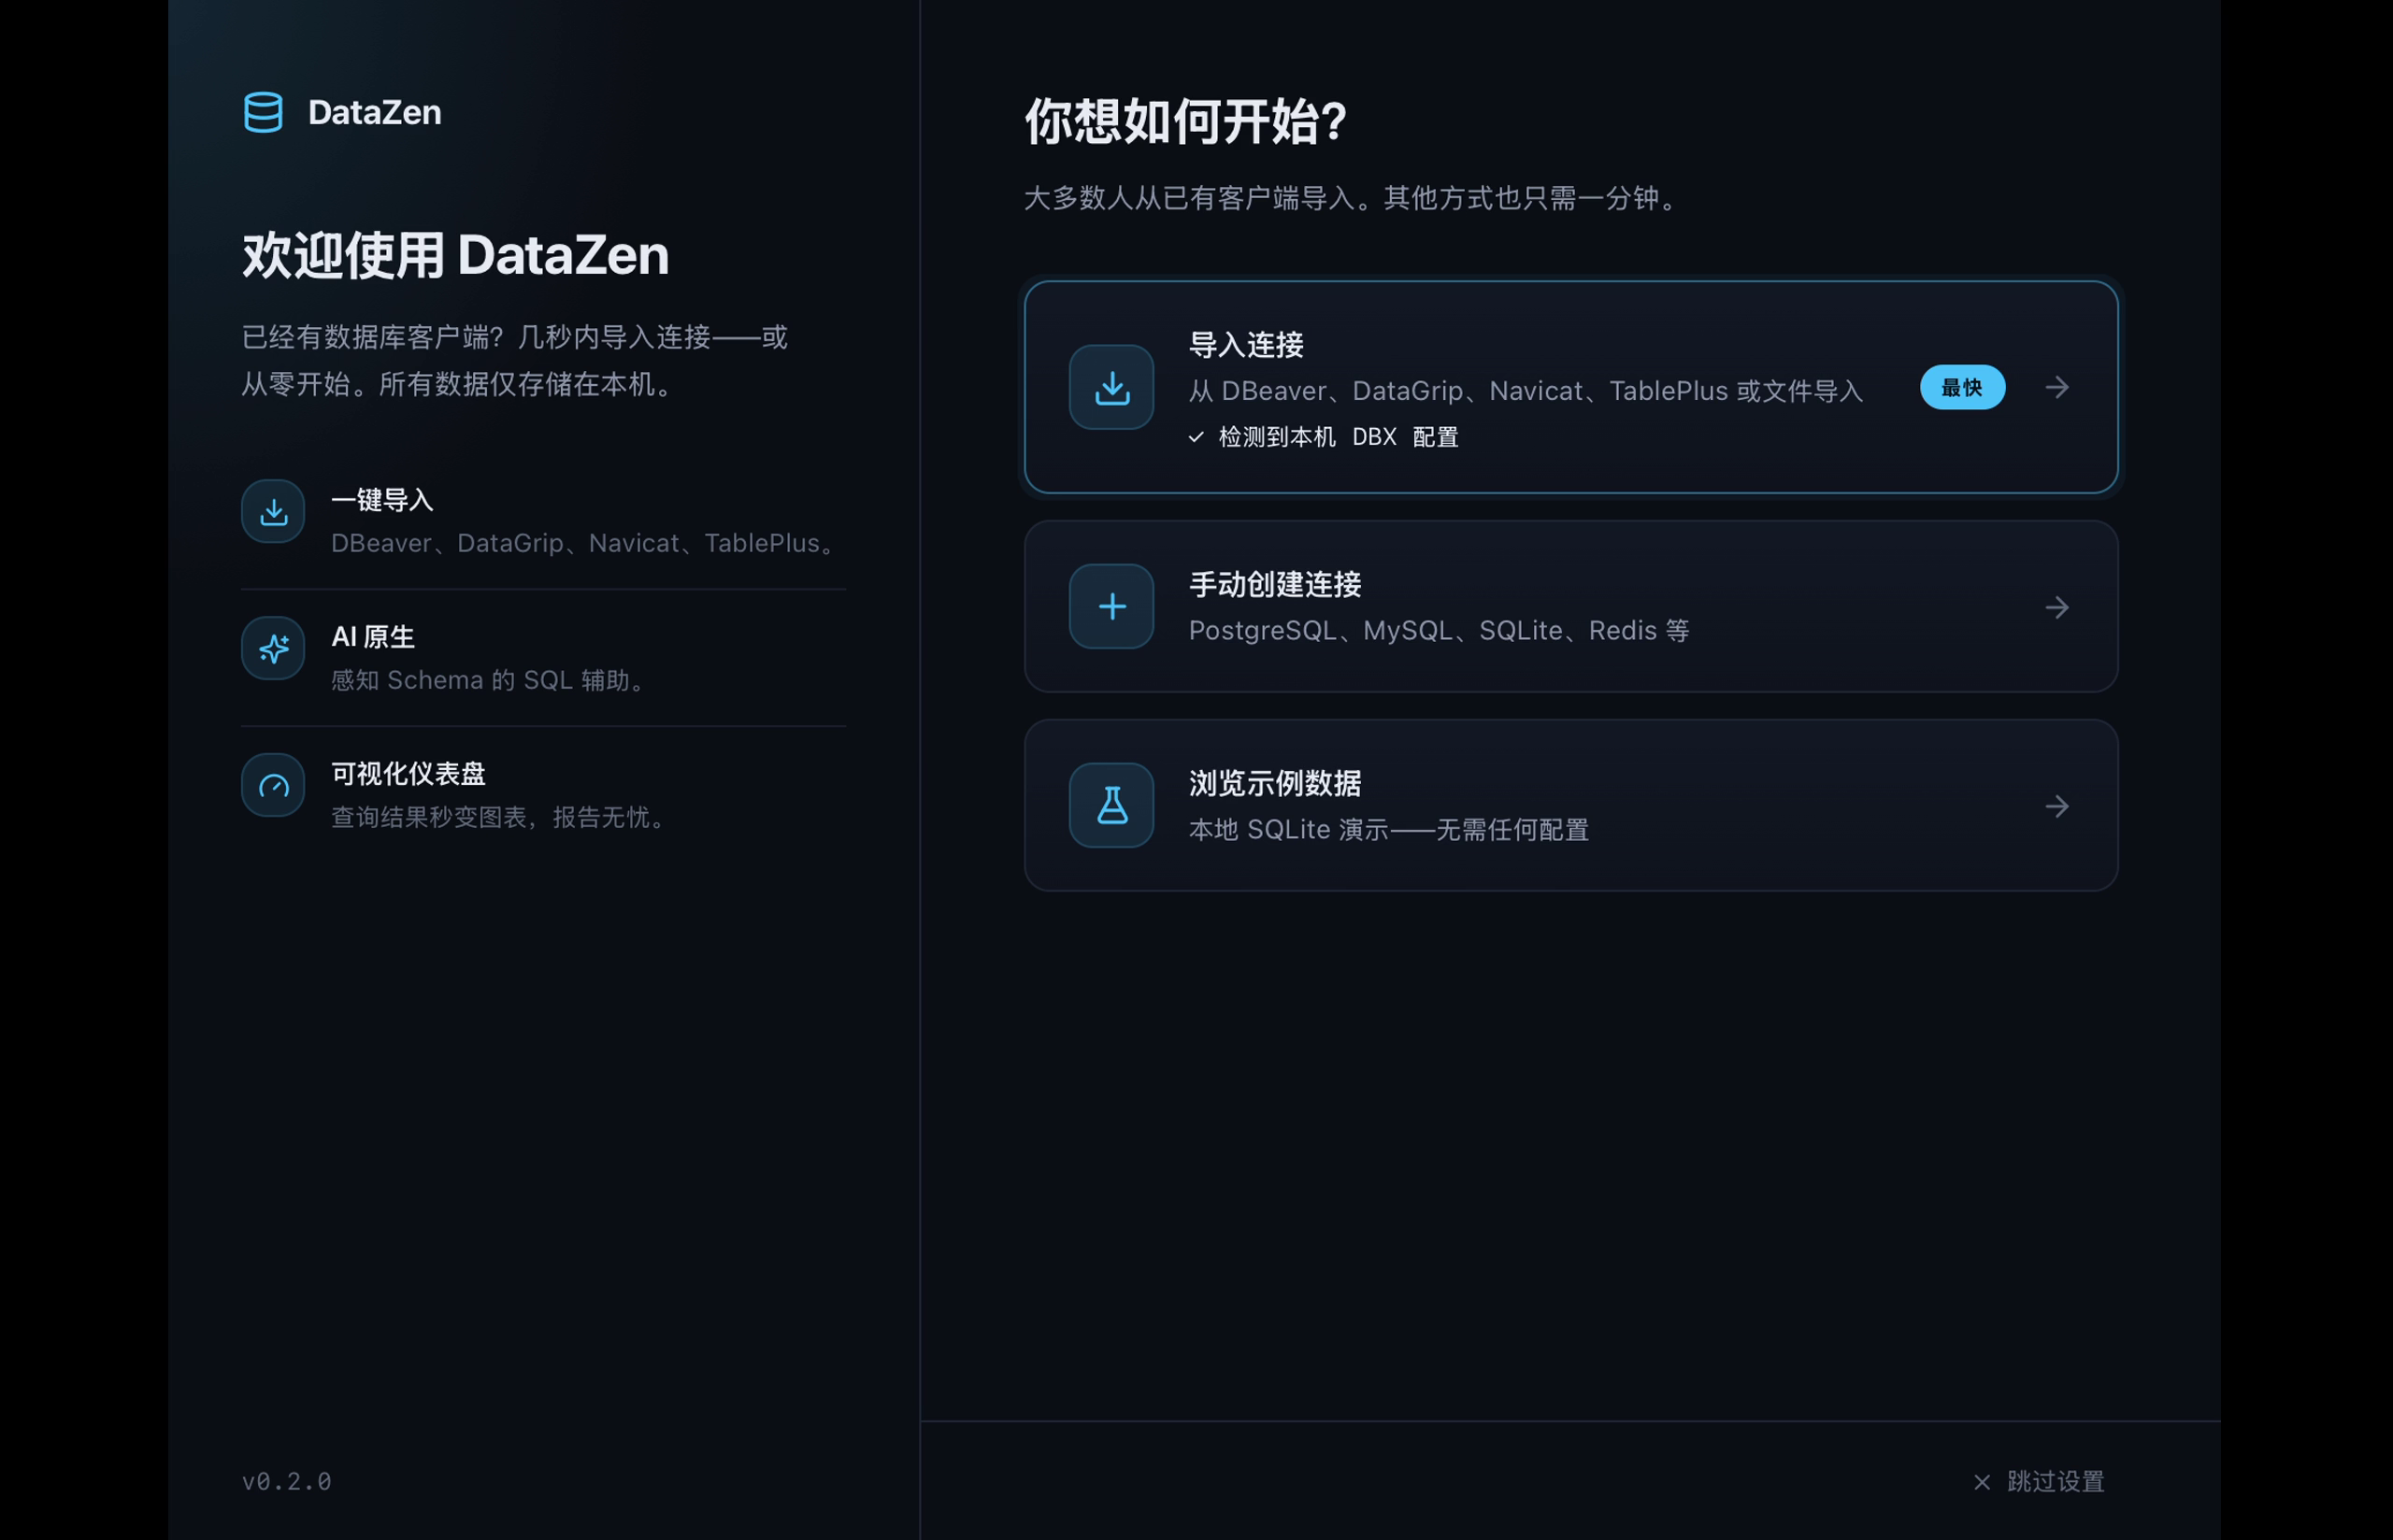
- 首次运行引导向导:3 步快速上手(连接示例库 → 探索 AI → 开始使用),8 种语言,状态可恢复。
- 4 模式执行策略:Run Current / Run All / Run Selection / Ask ,工具栏一键切换。
- SQL Snippets 管理:设置页自定义代码片段,实时注入编辑器补全。
- Paste as IN:
Cmd+Shift+V一键将多行文本转为IN ('a', 'b')。 - 危险执行拦截:无 WHERE 的 UPDATE/DELETE 强制红色弹窗二次确认。
- 占位符防 NULL:未赋值参数直接拦截,防止隐式全表更新。
- Schema Diff DAG 拓扑排序:按外键依赖顺序生成 DDL ,避免引用目标缺失报错。
- Extension Points 热插拔:运行时加载 SQL Editor Pro 扩展,CodeMirror Compartment 动态重组。
- EP 签名验证:扩展包防篡改校验。
- 暗色主题全面刷新 + 亮色主题微调。
- i18n 领域包架构:14 个领域包按需惰性加载,首屏更小。
- 四维扩展体系:Driver / Theme / EP / Wapp ,为插件商店生态奠基。
- E2E 并行化:分组并行 + 每 worker 独立数据库,CI 更快更稳。
- 官网重塑:去 AI 味、Hero 重写、场景卡片、SEO 结构化数据。
一句话总结 DataZen 的定位: DataZen 适合作为日常开发、排查问题、本地调试时的一个轻快、顺手、不占内存的开源替代品。如果你的业务重度依赖复杂的数据库端存储过程编写或大型商业库,DataGrip 依然是更专业的选择;但如果你受够了厚重和慢,想找一个干净、轻量、平时挂在后台没负担的现代客户端,DataZen 会很适合你。
开源地址与下载
- GitHub 代码仓库:https://github.com/flyxl/datazen (如果觉得还过得去,求个 Star 鼓励一下 ⭐)
- v0.2.0 Release 下载:https://github.com/flyxl/datazen/releases/tag/v0.2.0
业余项目难免有考虑不周或者小 bug ,非常欢迎各位 V 友试用体验。如果遇到任何卡顿、报错,或者有想吐槽的交互,直接在帖子里回复或者提 GitHub Issue ,我都会认真拜读和迭代。
同时也欢迎各位一起来共建 DataZen ,做一款属于我们自己的软件!
谢谢大家!


 Select Language